ADFound: A Foundation Model for Diagnosis and Prognosis of Alzheimer’s Disease
ADFound: A Foundation Model for Diagnosis and Prognosis of Alzheimer’s Disease
Abstract
- 기존의 multimodal AD 모델은 특정 작업에 특화되어 있고, 일반화 능력이 부족함
- 최초의 AD용 multimodal foundation model ADFound 제시
- Unpair 데이터, unlabeled 데이터 포함한 학습
- 장거리 의존성 파악 위한 Vision Mamba 기반 인코더
- Multimodal MAE와 Contrastive Learning 통합
Introduction
- AD의 clinical한 동기
Medical 분야의 데이터 특성 상 annotation 부족해 학습 어렵고 모델의 일반화 능력은 학습된 task에 의해 제한됨
→ 이를 해결한다면 SSL 방식의 학습, pretrain 후 linprob/lora ft 등 소수 파라미터 튜닝으로 downstream?
- 대부분의 AD 분야 모델들은 단일 모달 데이터 이용 → 부정확한 설명인 것 같음, multimodal 연구 다수 존재
- Medical 분야에서 Vision foundation model 다수 등장했음에도 AD에 적용에는 challenge 존재
- ViT의 높은 complexity로 인해 3D 영상에 비효율적
- MAE, Contrastive learning 전략 단일 사용 → 상보적 objective 통합성 필요
- Paired multimodal 데이터에 의존한 학습
ADFound
- Vision Mamba 기반 모델 사용해 complexity 절감
- MAE와 이중 contrastive learning 통합한 구조
- 동일 modality 표현력 향상을 위한 intra-CL
- paired modality 표현력 향상 위한 inter-CL
Contribution
- Unpaired 데이터를 포함한 대규모 unlabeled multimodal 데이터로 학습한 AD foundation 모델
- Multimodal Vim 인코더 개발
- Dual contrastive learning을 MAE에 통합하는 SSL 전략 제시
- 광범위한 실험 통한 성능 검증
Method
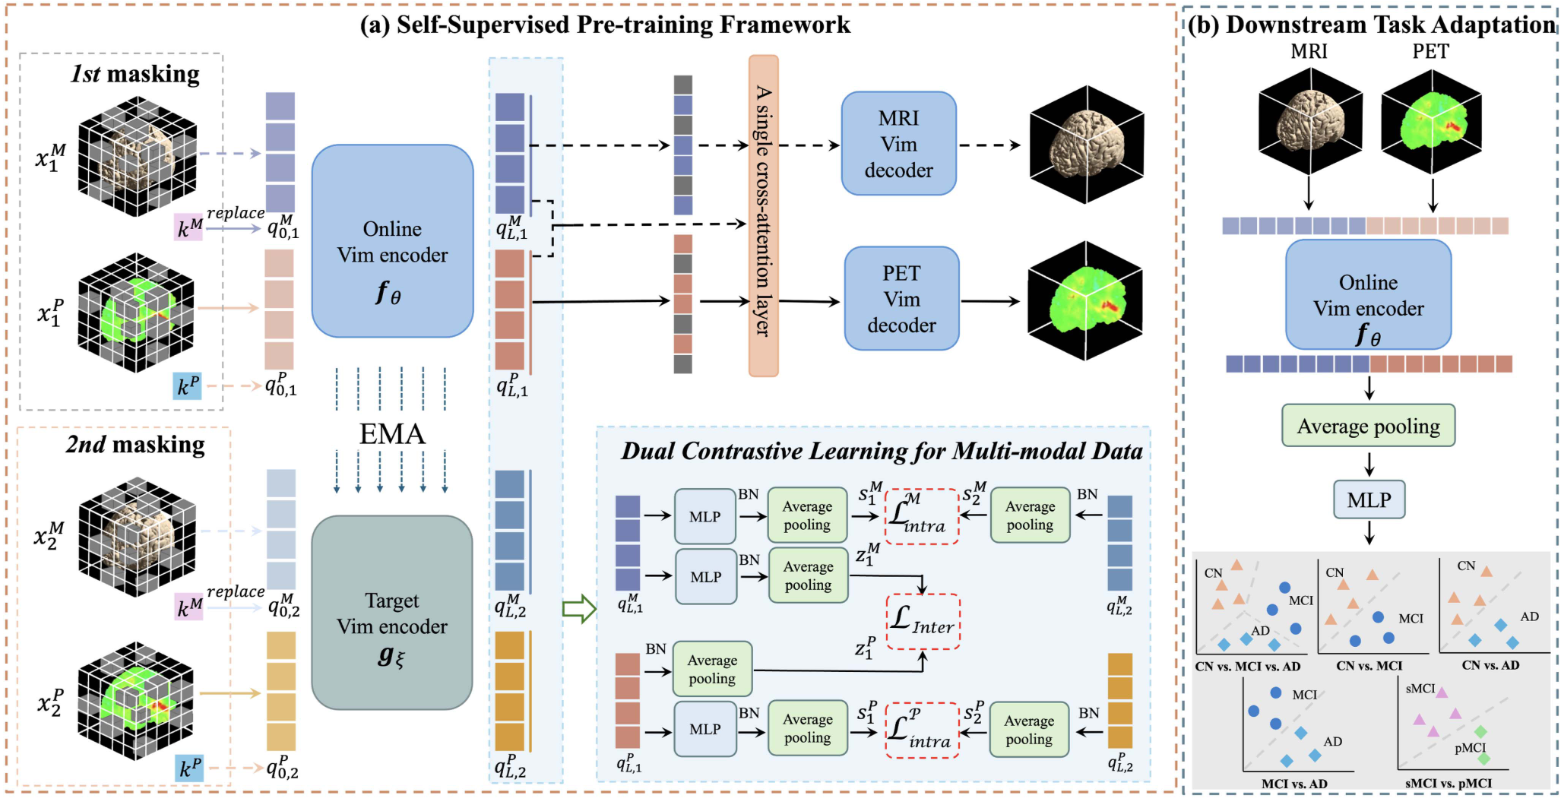
Image Patch Embedding
- 3D T1과 PET 영상x_{M/P} \in \mathbb{R}^{C \times D \times W \times H}을 3D patch {v_{M/P}^j \in \mathbb{R}^{O^3 \cdot C}}_{j=1}^J로 분할
- M/P : T1 MRI 또는 PET, modality 표기
- O : 3D patch size
- J : 총 patch 수
- M/P : T1 MRI 또는 PET, modality 표기
- O : 3D patch size
- J : 총 patch 수
- 각 Patch를 linear projection 후 1D position embedding 더해 image patch embedding q 생성
Multi-Modal Vim Encoder
- Multimodal embeded token sequence Q 를 입력으로 받아 Vim encoder에 입력
- Encoding된 latent representation Q_L 획득
- Unpaired 입력(Modality가 누락되는 경우)에 대해서는 해당 modality의 embedded token sequence를 learnable token k^{M/P}로 대체
- learnable token으로 결측 대체
→ 각 Subject의 특성이 반영되지 않음 ⇒ learnable token은 해당 modality를 대표하는 값으로 수렴
⇒ 이후 CL과 MAE 모두 결측 modal에 대해 계산하지 않음, 그렇다면 왜 두 modality를 한번에 encoding하는 encoder 구조를 채택했는가?
- learnable token으로 결측 대체
→ 각 Subject의 특성이 반영되지 않음 ⇒ learnable token은 해당 modality를 대표하는 값으로 수렴
⇒ 이후 CL과 MAE 모두 결측 modal에 대해 계산하지 않음, 그렇다면 왜 두 modality를 한번에 encoding하는 encoder 구조를 채택했는가?
Multi-Modal MAE
- Reconstruction을 위해 modality 별 decoder 구조 채택
- 입력 modal의 이미지는 patch로 분할된 후 무작위 masking됨
- 남은 patch만 embedding되어 Vim encoder 통과해 latent representation [q^M_{L,1}, q^P_{L,1}] 출력
- masking 위치에 대응되는 learnable mask token과 latent representation 합쳐져 Query로 사용
- Key, value로 concat된 latent representation 사용해 cross-attention 수행
- cross-attention 출력을 이용해 reconstruction 후 loss 계산
- Pixel MSE loss
- Pixel MSE loss
Dual Contrastive Learning for Multi-Modal Data
Intra-Modal Contrastive Learning Module
- EMA로 update 되는 target encoder g는 동일 입력에 대해 online encoder f와 독립적인 masking 후 encoding 진행
- 동일한 modality 입력에 대한 판별 특징 포착하도록 학습시키는 목적
두 encoding 표현에 대해 online encoder 출력에만 projection을 진행, 각각 batch normalize와 average pooling해 두 표현을 얻음
\[\boldsymbol{q}_{L,1}^{M/P}, \boldsymbol{q}_{L,2}^{M/P} = \boldsymbol{f}_{\theta}(\boldsymbol{q}_{0,1}^{M/P}), \boldsymbol{g}_{\xi}(\boldsymbol{q}_{0,2}^{M/P}), \\ \mathbf{s}_{1}^{M/P}, \mathbf{s}_{2}^{M/P} = \mathcal{P}(\text{Mean}(\mathbf{q}_{L,1}^{M/P})), \text{Mean}(\mathbf{q}_{L,2}^{M/P})).\]
- 표현 간 similarity 계산해 InfoNCE loss에 사용
- positive sample은 동일 subject, 동일 modality의 서로 다른 encoder 출력
- positive sample은 동일 subject, 동일 modality의 서로 다른 encoder 출력
Inter-Modal Contrastive Learning Module
- Online encoder의 출력만 이용해 계산
- 동일 subject의 서로 다른 modality 표현을 positive sample로 간주
T1의 representation에만 projection 진행
\[\boldsymbol{z}^{M}, \boldsymbol{z}^{P}=\mathcal{P}\left(Mean\left(\boldsymbol{q}_{L, 1}^{M}\right)\right), Mean\left(\boldsymbol{q}_{L, 1}^{P}\right) \\ \chi = \frac{z^M \cdot z^P}{||z^M||_2 \cdot ||z^P||_2}\]
→ 왜 일부 representation에만 projection 수행했는가..?
Downstream Task Adaptation
- GAP와 MLP 사용해 finetuning 수행
- Cross Entopy loss 사용
Overall Training Objective
- 2단계로 분리해 학습 수행
Result
Data
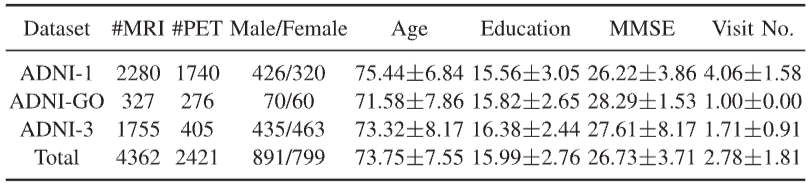
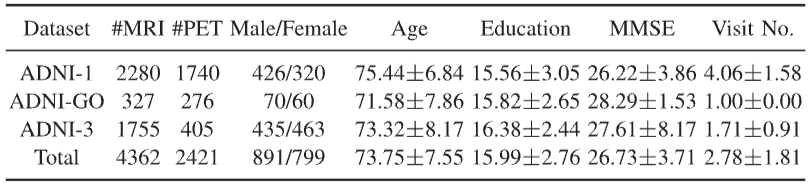
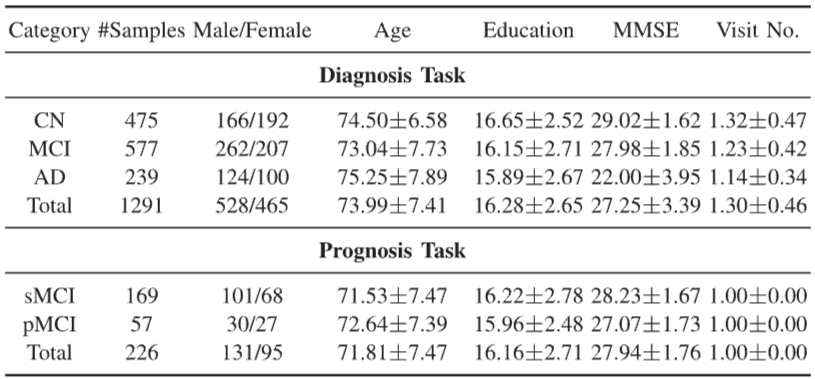
- ADNI
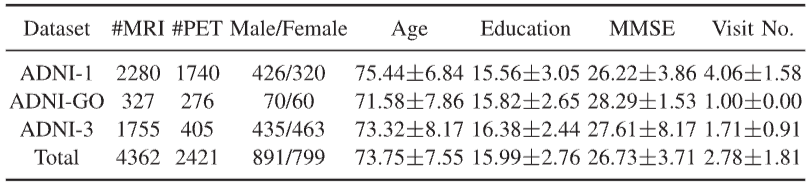
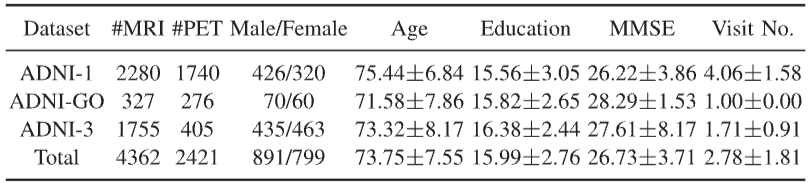
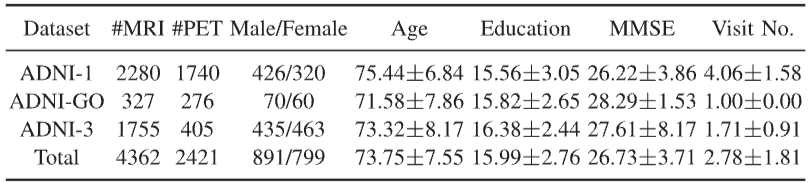
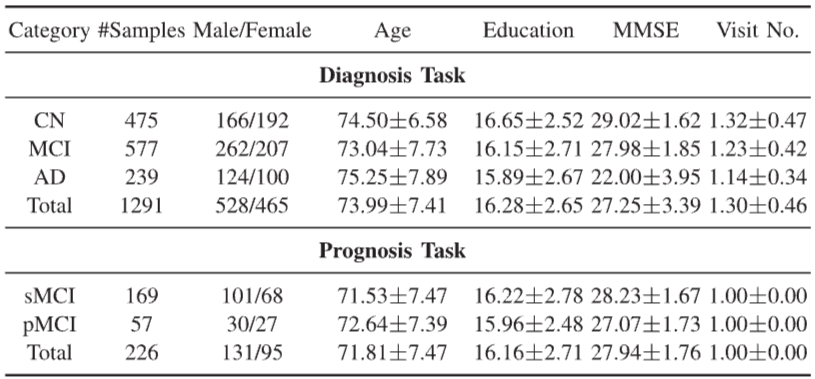
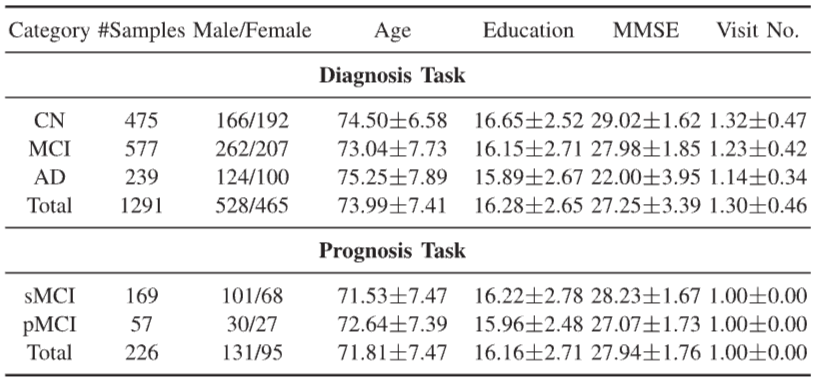
- OASIS-3
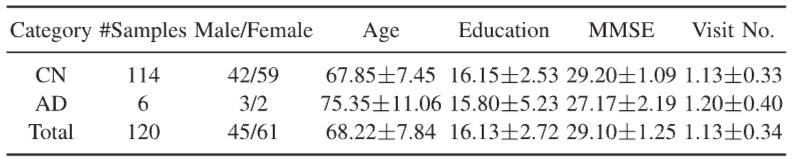
Experiments
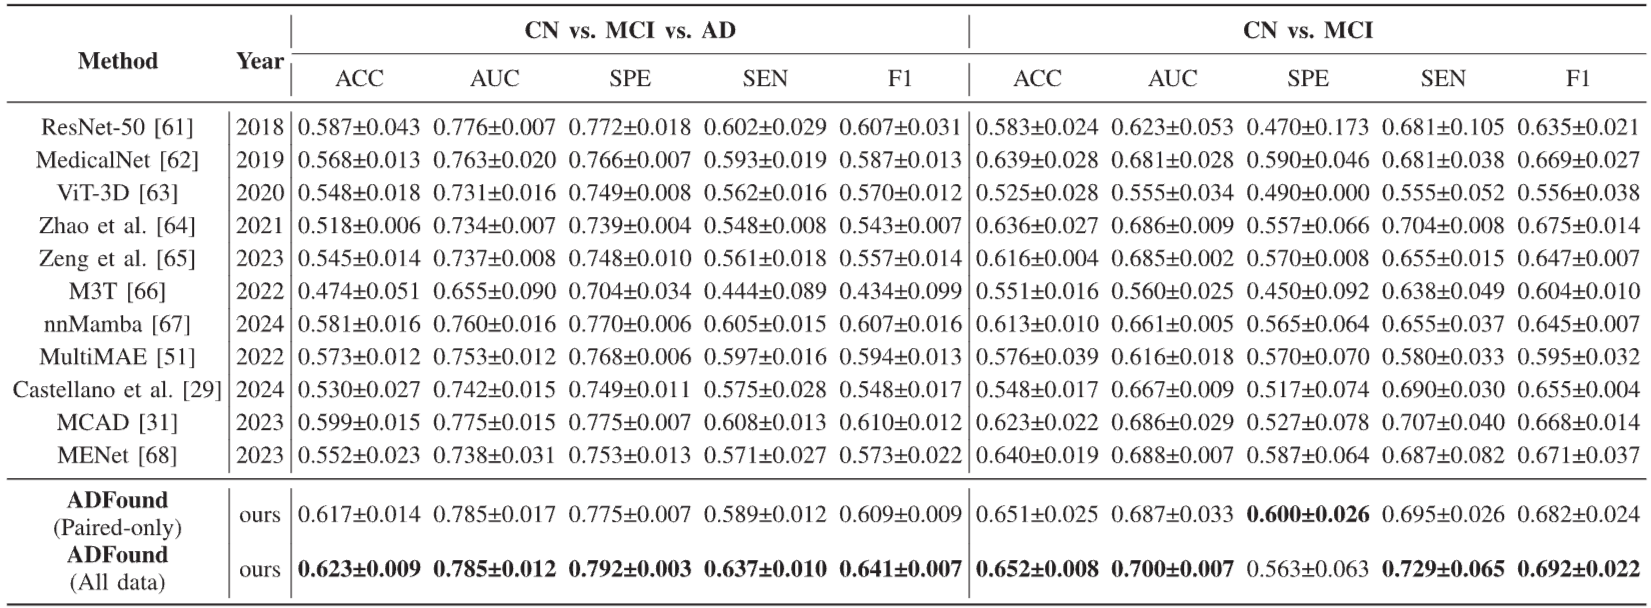
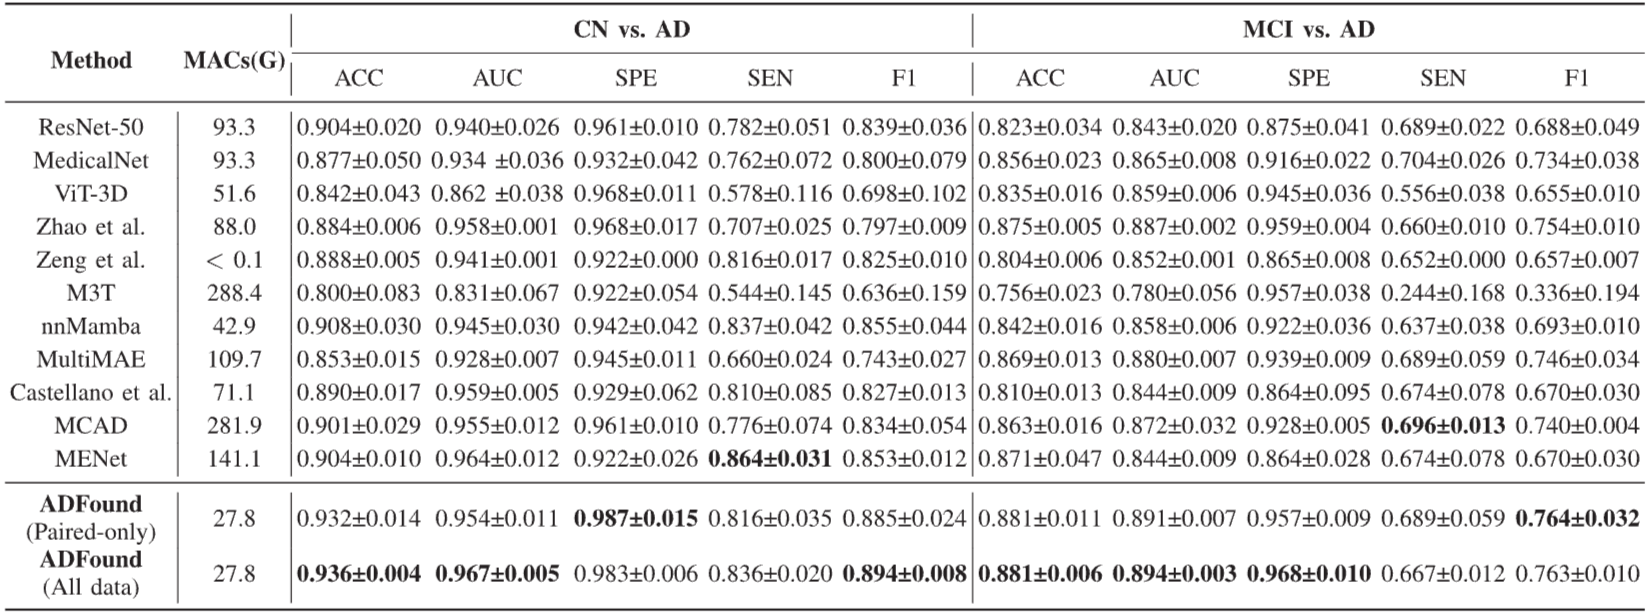
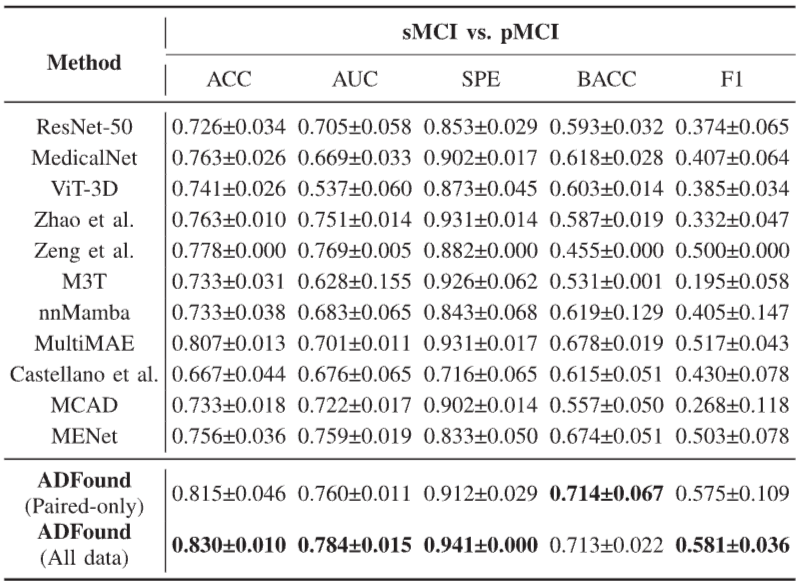
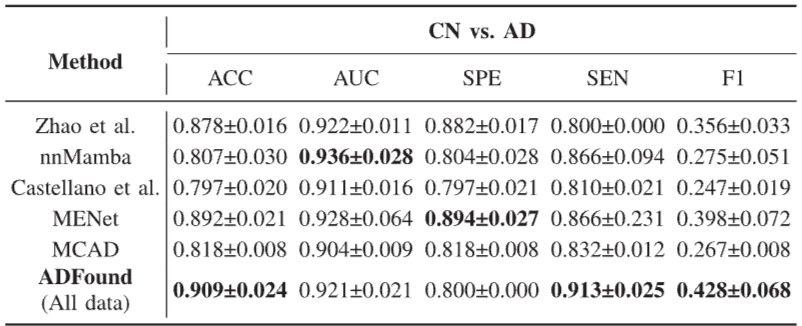
- Oasis
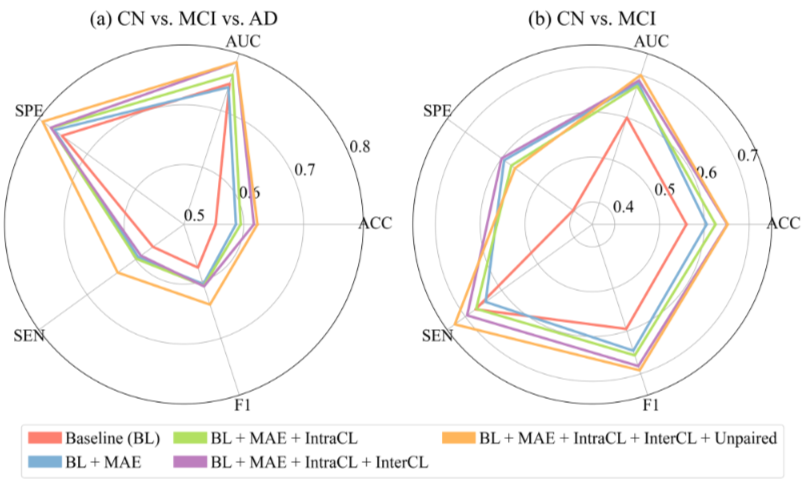
- Ablation
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.